Puppeteerがゾンビになってサーバーを食い尽くした話
2026.09.24こんにちは。NANAシステム開発のSYです。
ある日、パフォーマンスが極端に落ちたという連絡を受けてサーバーのメモリ使用量を見ていたら、
「なんか異様にメモリが減ってるな……」
というところから始まりました。
最初は定番の犯人であるSQL Serverを疑いました。
しかし調査してみると、SQL Serverは設定どおりで40GB以上は使っていません。
「じゃあ誰が食べたんだ?」
と思って確認すると、犯人は別のところにいました。
犯人はPuppeteerだった
PDF作成機能では、Puppeteerを利用しているんですが、その日、大量のPDF出力処理が一斉に実行されていました。
件数を確認すると、350件以上。
当然その分だけChromiumプロセスも大量起動されますが、ここまでは想定内でした。
問題はその後です。
PDF生成でエラー発生
PDF出力処理の途中でエラーが発生。
普通ならエラー時にPuppeteerは綺麗に終了します。
しかし今回は何らかの理由で終了処理までたどり着かなかったようです。
結果として、
- ●PDF作成は失敗
- ●Puppeteerは残る
- ●さらに大量実行中
という非常に嫌なコンボが完成しました。
気が付くと350体いた
プロセス一覧を見た瞬間、「なんかめちゃくちゃいるな」という感想しか出ませんでした。
調査すると、Puppeteerプロセスが約350件残存。しかも親プロセスがいません。完全にゾンビ化しています。イメージとしては「会社が倒産したのに社員だけ350人残ってる」
みたいな状態です。
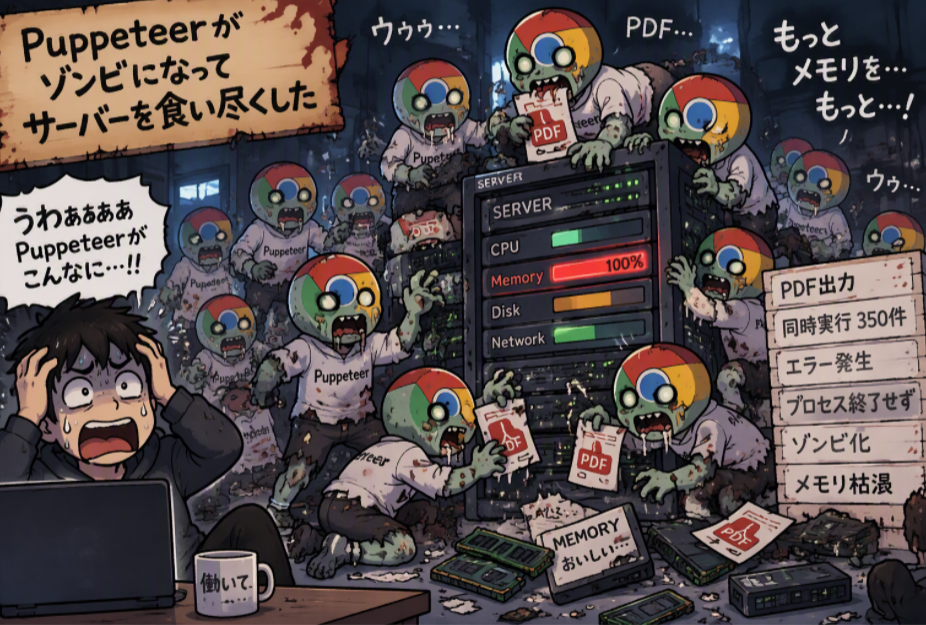
ゾンビプロセス爆誕
さらに厄介だったのが、プロセス達がゾンビ状態になっていたこと。親プロセスがいないため、「親プロセスをKillして道連れKill!」ができません。一括で回収できれば良かったのですが、それができない。しかも数が350件。
メモリが消えていく
ゾンビ化したPuppeteer達は解放されず居座り続けます。結果として、
- ●メモリ消費増加
- ●システム全体が重くなる
- ●サーバー操作も困難になる
という状態に。
サーバー再起動すらできない
こういう時の最終奥義は再起動です。しかし今回はそれすら難しい状況でした。メモリ不足の影響でサーバーがまともに応答してくれません。つまり、「再起動しようにも再起動できない」状態。なかなかの地獄です。
最終手段
結局どうしたかというと、地道に1件ずつKillしました。
復旧
Puppeteerを順番に強制終了していくと、徐々にメモリが回復。最終的には正常値まで戻り、サービス継続可能な状態になりました。今回の障害はこれで解消です。
今後の対策
今回の反省を踏まえて、以下を実施しました。
短期対応
- ●メモリ監視強化
- ●閾値超過時のアラート通知
- ●障害時の対応手順整備
- ・サーバー再起動
- ・Puppeteer個別Kill
恒久対策
- ●プロセス消失時のセルフキル
- ●タイムアウト制御
何事も、予兆を検知することが大切だなと思った話でした。